想定読者
数名規模でマーケティングや広報を担当している方、あるいは経営者が兼任でマーケティング業務を行っている中小企業の方を想定しています。
外部の調査会社に依頼する予算や時間は確保しにくいものの、日々集まる顧客の声やアンケート回答、レビューをもっと活用したいと考えている方に向けた内容です。
要点
- 生成AIは「新しい統計的事実」を発見する道具ではなく、仮説出しや分類作業を速くする道具として位置づけると失敗しにくい
- 顧客の声やアンケート回答をAIに渡す前に、氏名・メールアドレスなどの個人情報をマスキング(見える形で残さないよう伏せ字や削除にすること)する手順を必ず挟む
- AIが出した傾向や要約は、件数・偏り・具体例の3点を自分の目で検証してから施策に反映する
なぜ今、中小企業にもAIマーケティングリサーチが必要か
外部調査に頼れない中小企業が抱えるリサーチの壁
大手企業であれば、外部の調査会社にアンケート設計やインタビュー分析を委託し、時間をかけて市場動向をまとめてもらうことができます。
しかし数名規模の企業では、そもそも調査予算がなく、担当者が本業と兼任でリサーチ業務を回していることがほとんどです。
結果として、顧客からの問い合わせメールやレビュー、SNSの声は「目は通しているが、まとめて分析する時間がない」まま埋もれてしまいがちです。
こうした状況で頼りになるのが、日々の業務の中で少しずつ蓄積されている一次情報、つまり自社が直接得た顧客の声です。
問い合わせ対応の記録、アンケートの自由記述欄、ECサイトのレビュー欄などは、外部調査に頼らずとも手元にある貴重なデータです。
課題は「データがない」ことではなく、「時間をかけて読み込み、傾向を整理する余裕がない」ことにあります。
AIが変えるのは「調査」ではなく「仮説出しのスピード」
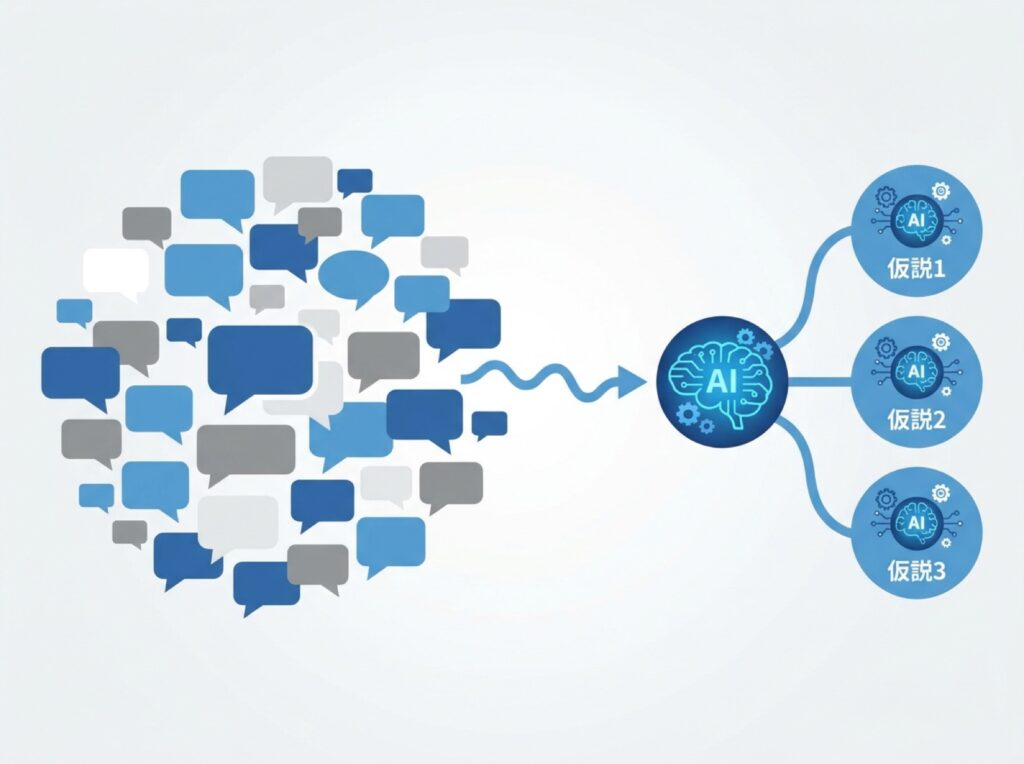
生成AI(文章の要約や作成を自動で行うAIサービス)は、こうした「読み込んで整理する」作業を大幅に速くしてくれます。
ただし注意したいのは、生成AIが行っているのはあくまで既存のテキストデータの要約・分類・仮説出しであり、AI自身が新しい市場の真実を発見しているわけではないという点です。
たとえば100件のレビューをAIに読み込ませて「価格に関する不満が多い」という傾向が返ってきたとしても、それは統計的に検証された事実ではなく、AIがテキストのパターンから導き出した仮説にすぎません。
この仮説を出発点として、実際のレビュー件数や具体的なコメントを自分の目で確認し、施策に落とし込むかどうかを判断するのは、あくまで担当者の役割です。
生成AIを「リサーチ担当者の代わり」ではなく「リサーチ担当者の下読み・下書きを担うアシスタント」と位置づけることで、過度な期待による失敗を避けられます。
レビュー・SNSの声をテキストマイニングする
ECサイトのレビューやSNSの投稿は、顧客の本音が表れやすい情報源です。
件数が数十件程度であれば人力でも読み込めますが、100件、200件と増えてくると全体像をつかむのが難しくなります。
ここで生成AIにレビュー本文をまとめて渡し、「繰り返し出てくる話題」を分類させると、テキストマイニング(大量の文章データから傾向や話題を抽出する作業)に近いことを短時間で行えます。
実務では、次のようなプロンプト(AIへの指示文)の型が使えます。
あなたはBtoC商品のカスタマーレビューを分析するマーケティングアシスタントです。
以下は自社ECサイトに寄せられたレビュー本文30件です(氏名等は伏せてあります)。
[レビュー本文をここに貼り付け]
これらのレビューを読み、繰り返し出てくる話題を5つ以内に分類し、それぞれについて「話題名」「該当しそうな件数の目安」「代表的な表現の引用」を箇条書きで出力してください。
件数が少ない話題は無理に含めず、推測であることが分かる場合はその旨を明記してください。
この型のポイントは以下の3点です。
- AIに「マーケティングアシスタント」という役割を与える
- 入力データ(レビュー本文)をそのまま貼り付ける
- 出力フォーマット(話題名・件数目安・引用の3項目)を明確に指定する
役割・データ・出力形式を指定しないまま「このレビューを分析して」とだけ頼むと、出力の粒度がそのつど変わってしまい、比較や検証がしにくくなります。
アンケート自由記述・インタビュー記録を要約・分類する
顧客満足度アンケートの自由記述欄や、対面・オンラインで行った簡単な聞き取りの記録も、AIによる要約・分類が活きる領域です。
自由記述は「言いたいことを自由に書いてもらう」形式のため、回答者ごとに文章量も切り口もばらばらになりがちで、人力で読み込むと時間がかかります。
あなたは自社サービスの顧客満足度アンケートを分析する担当者です。
以下は自由記述欄への回答20件です(個人が特定できる情報はA様、B様のように置き換えてあります)。
[自由記述の回答をここに貼り付け]
回答を「良かった点」「改善してほしい点」「その他・分類しづらい意見」の3つに分類し、それぞれの件数と、代表的な回答を1〜2件ずつ引用してください。1件の回答に複数の内容が含まれる場合は、両方のカテゴリーに数えてよいものとします。
インタビュー記録についても同様に、逐語録(発言をそのまま文字にした記録)をAIに渡し、「話者ごとに発言の要点を3行以内でまとめてください」といった指示を出すことで、聞き取り直後の記憶が新しいうちに要点を整理しやすくなります。
ただし逐語録には個人情報や機微な発言が含まれやすいため、次の章で説明するマスキング手順を必ず挟んでください。
既存データ(GA4・購買履歴)と組み合わせてペルソナ仮説を作る
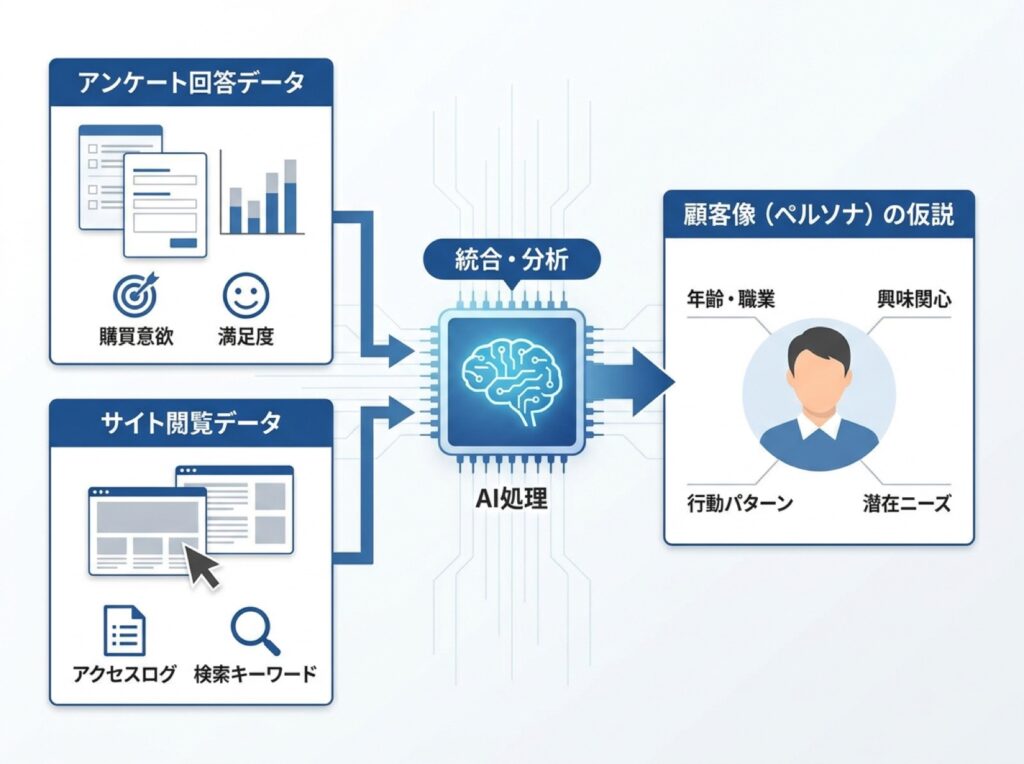
レビューやアンケートのテキスト分析に加えて、アクセス解析ツール(サイトへの訪問状況を計測するGA4など)の閲覧データや購買履歴などの数値データと組み合わせることで、より具体的な顧客像、いわゆるペルソナ(架空の典型的な顧客像として設定する人物モデル)の仮説を作ることができます。
あなたはBtoC企業のマーケティング担当を支援するアシスタントです。
以下は、あるサービスについての「顧客アンケートの要約結果」と「サイト閲覧データの要約(流入経路・よく見られるページ・平均滞在時間)」です。
[アンケート要約をここに貼り付け]
[サイト閲覧データの要約をここに貼り付け]
この2つの情報から想定できる顧客像を2〜3パターン、それぞれ「主な関心事」「利用シーン」「懸念点」の3項目で箇条書きにしてまとめてください。
断定はせず、あくまで仮説である旨を明記してください。
ここで作られるペルソナは、あくまで「仮説」です。
実在の顧客一人ひとりを正確に言い当てるものではなく、次の施策(訴求文言の見直しや問い合わせ対応の改善など)を検討するためのたたき台として使うのが適切です。
実践ステップ:データ準備からプロンプト設計まで
個人情報・機微情報をマスキングする手順
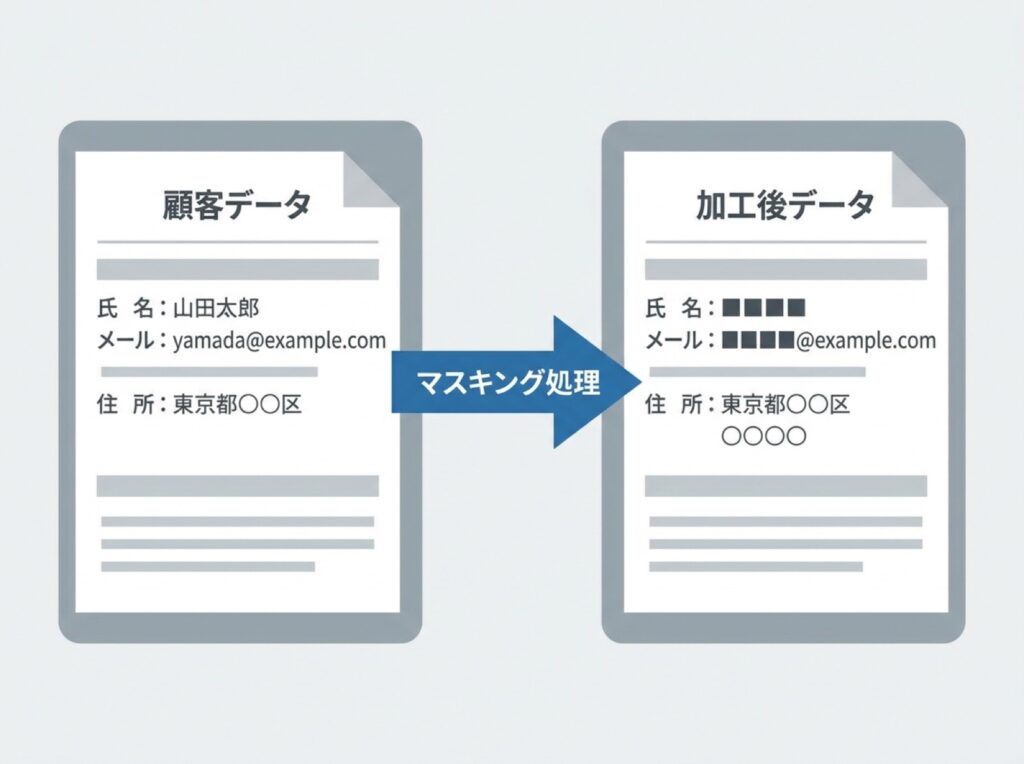
顧客の声をAIに渡す前には、必ず個人情報や機微な情報を取り除く「マスキング」の工程を挟んでください。
生成AIチャットツールの多くは入力内容を学習に利用しない設定を選べますが、設定の有無にかかわらず、社外のサービスに個人情報をそのまま送らないことを基本のルールにしておくと安全です。実務では、次のような置き換えを行います。
- 氏名は「A様」「Bさん」のような仮の呼び方に置き換える
- メールアドレス・電話番号は完全に削除する
- 住所は「〇〇県〇〇市」など市区町村レベルまでに丸め、番地以降は削除する
- 会社名・部署名など、組み合わせると個人や取引先が特定できてしまう情報は伏せ字(〇〇社など)にする
- 生年月日は年代(30代など)までに丸める
- 商品の不具合報告など、個別の契約内容や金額が特定できる記述は要約し直してから渡す
これらの作業は、レビューやアンケートの件数が多いとそれ自体に手間がかかります。
あらかじめ社内で「アンケートの氏名欄は集計時に削除する」「自由記述に固有名詞が含まれていないか事後チェックする」といった運用ルールを決めておくと、マスキングの手間を毎回ゼロから考えずに済みます。
使えるプロンプトの型(役割・データ・出力形式を指定する)
ここまでの例に共通しているのは以下の3つの要素です。
- 役割の指定
- 入力データの渡し方
- 出力フォーマットの指定というこの型を崩さずに使うこと
AIの出力のばらつきを抑え、後から検証しやすい形で結果を受け取れます。
- 役割の指定:「あなたは〇〇を分析するマーケティングアシスタントです」のように、AIに担ってほしい立場を明示する
- データの渡し方:分析対象のテキストをそのまま貼り付け、件数や取得時期などの前提条件も添える
- 出力フォーマットの指定:箇条書きか表か、項目数の上限、件数の記載有無などを具体的に指示する
慣れてきたら、「まず自分で3件ほど読んで気になる論点を洗い出してから、AIに全体の傾向を聞く」という順番にすると、AIの出力が実態とずれていないかを判断しやすくなります。
出力を検証する3つのチェックポイント
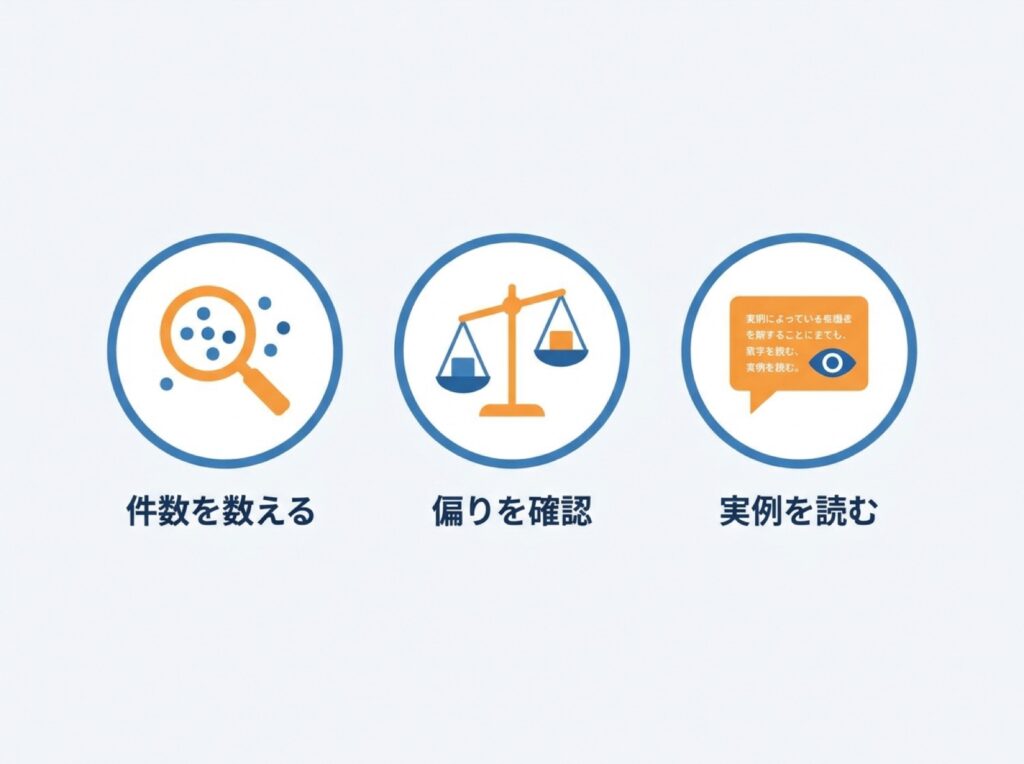
AIが返した傾向や要約は、そのまま施策に使わず、次の3点を自分の目で確認してから採用してください。
- 件数:「多い」「よくある」といった表現の裏にある実際の件数を確認する。全体の中でごく少数の意見が「傾向」として拡大解釈されていないか
- 偏り:回答者の属性(既存顧客か新規顧客か、購入直後か数か月後かなど)に偏りがないか。特定の顧客層の声だけが強く反映されていないか
- 具体例:AIが要約した内容に対応する、実際の生の発言を1〜2件は自分で読んで確認する。AIの要約が元の文章のニュアンスを取り違えていないか
この3点を毎回確認する習慣をつけることで、AIの出力を鵜呑みにするリスクを減らせます。
注意点と落とし穴
ハルシネーション(存在しない傾向の生成)を防ぐ
生成AIは、入力されたデータに実際には含まれていない傾向や数値を、もっともらしい文章として生成してしまうことがあります。
これはハルシネーション(AIが事実に基づかない内容をあたかも事実であるかのように出力してしまう現象)と呼ばれるもので、特に入力データの件数が少ない場合や、AIに「何かしらの傾向を見つけて」と曖昧に依頼した場合に起こりやすくなります。
これを防ぐには、プロンプトの中で「データに書かれていないことは推測せず、推測する場合はその旨を明記してください」という指示を必ず入れることが有効です。
加えて、出力された数値や件数は、必ず元データと突き合わせて確認する習慣をつけてください。
サンプル数・回答者の偏りを見落とさない
AIによる分析は、渡したデータの範囲でしか傾向を示せません。たとえばSNSで積極的に発信する一部の顧客の声だけを分析対象にすると、実際の顧客全体の傾向とはずれた結果が出やすくなります。
同様に、アンケートの回答者が特定のキャンペーン経由の顧客に偏っている場合、その結果を「顧客全体の声」として扱うのは危険です。
分析結果を報告・活用する際は、「何件中何件の意見か」「どのような顧客層からの回答か」という前提条件を必ず併記する習慣をつけると、後から見返したときにも判断を誤りにくくなります。
社外AIツールへのデータ入力ルールを社内で決めておく
ChatGPT/Claude/Geminiなどの生成AIチャットツールは、無料版・有料版を問わず、入力したデータの扱い(学習への利用可否、保存期間など)がサービスごとに異なります。
個人情報や機密情報を誤って入力してしまう事故を防ぐためにも、次のようなルールを社内であらかじめ決めておくことをおすすめします。
- 個人情報・取引先情報はマスキングしてから入力する(前述の「個人情報・機微情報をマスキングする手順」を参照)
- 使用するAIツールと、入力してよい情報の範囲を担当者間で共有する
- 判断に迷うデータは、入力前に上長や情報システム担当に確認する
- 契約書・見積書などの機密性が高い文書は、そもそもAIチャットツールに入力しない
小規模な組織ほど、こうしたルールが暗黙の了解のまま運用されがちです。
文書化された簡単なルールを1枚用意しておくだけでも、事故を防ぐ効果は大きくなります。
まとめ
生成AIは、中小企業がこれまで時間の制約から手をつけられなかった顧客の声の分析を、仮説出しと分類という形で後押ししてくれる道具です。
ただしAIが出す傾向や要約はあくまで叩き台であり、件数・偏り・具体例を自分の目で確認するプロセスを省略しないことが、AIリサーチを実務で安全に使いこなす鍵になります。
個人情報のマスキングや社内ルールの整備といった地味な準備を丁寧に行うことが、結果的にAIリサーチを長く安定して使い続けるための近道になります。
